Leistung der KI-Texterkennung
DetectRL-XACL 2026
99,5 %
Genauigkeit auf DetectRL-X


Wir prüfen die Erkennungsleistung für deutsche Texte mit DetectRL-X und untersuchen falsch positive Ergebnisse separat anhand von 4.589 authentischen Schüleraufsätzen aus DARIUS.
Die Leistung von It’s AI wird durch veröffentlichte Forschung und unabhängige Benchmarks belegt. Unsere MGTD-Ergebnisse stammen aus einer begutachteten Benchmark-Studie; das RAID-Ergebnis steht auf der offiziellen öffentlichen Rangliste. Beide Auswertungen beziehen sich auf englischsprachige Texte.
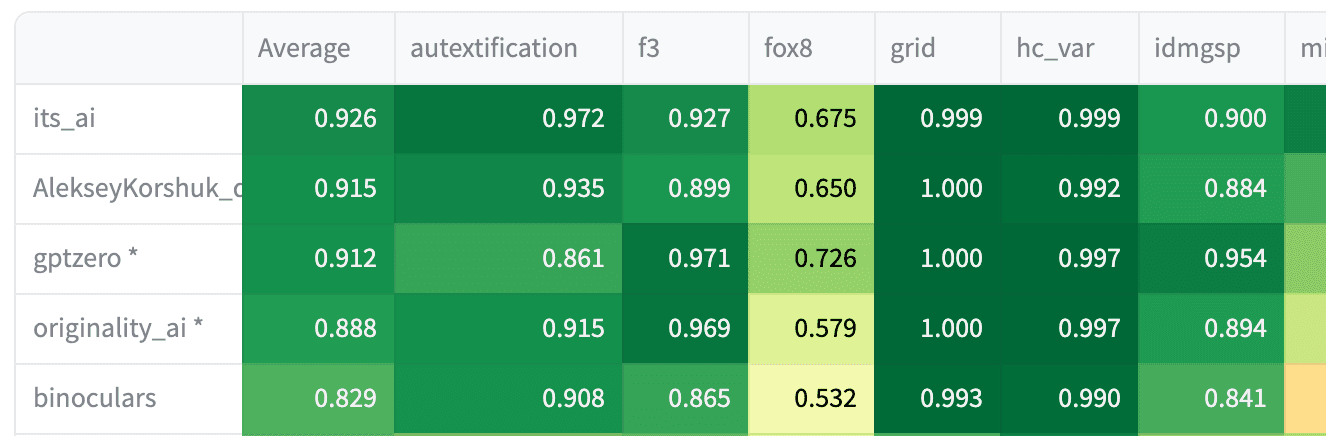
MGTD bündelt 15 Benchmark-Datensätze und knapp 2 Millionen Testbeispiele für einen direkten Vergleich führender KI-Detektoren. It’s AI erzielte den höchsten ROC-AUC-Wert, vor GPTZero, Originality AI, ZeroGPT und weiteren untersuchten Systemen.
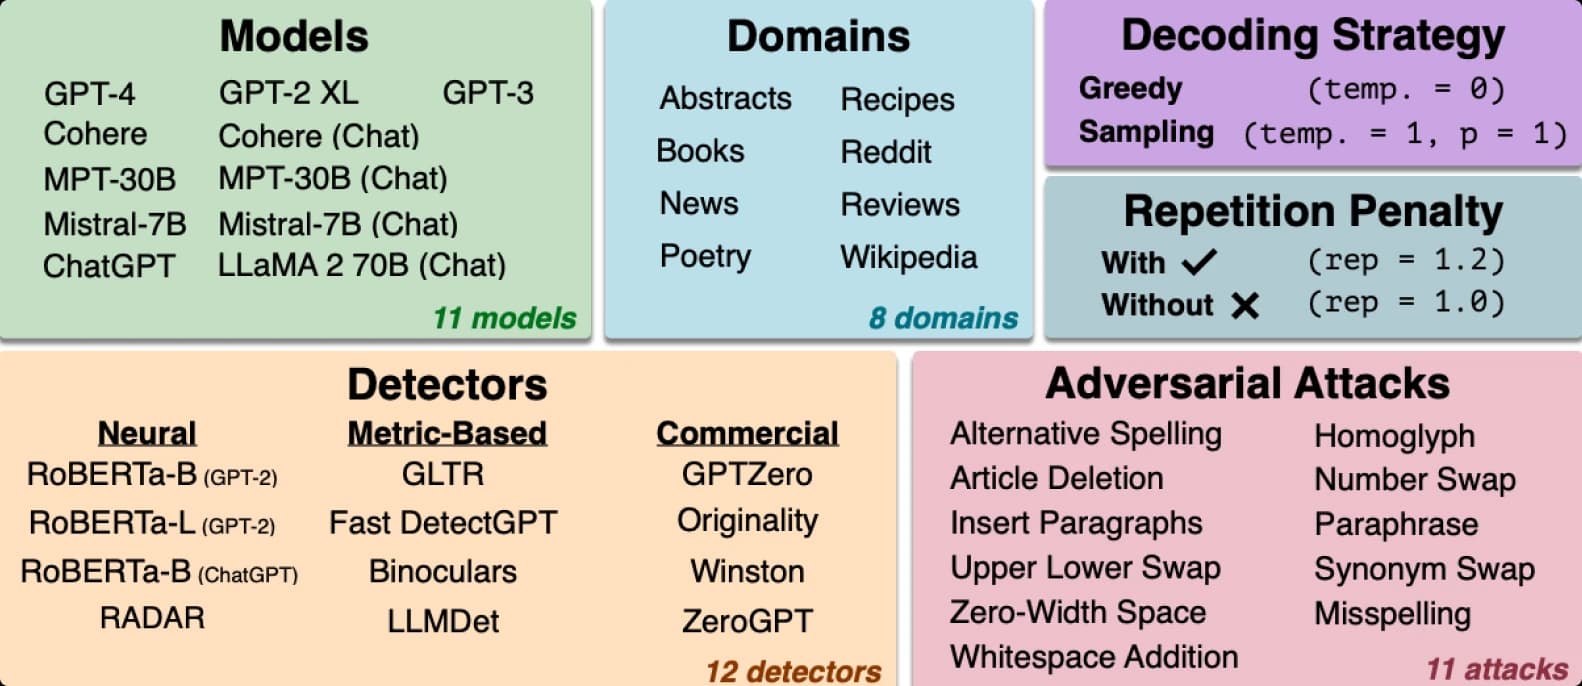
RAID prüft die Robustheit von KI-Detektoren über verschiedene große Sprachmodelle, Textbereiche, Dekodierungseinstellungen und gezielte Manipulationen hinweg. Dazu gehören Paraphrasen, Rechtschreibfehler, ähnlich aussehende Zeichen, veränderte Leerzeichen und weitere praxisnahe Veränderungen.
Jeder Benchmark verlinkt auf die zugehörige Studie, den Datensatz oder die offizielle Benchmark-Seite.
| Benchmark | Was wird geprüft? | Testdaten | Ergebnis von It’s AI |
|---|---|---|---|
| DetectRL-X Mehrsprachiger Benchmark mit praxisnahen Texten | KI-Texterkennung in sechs Textbereichen | 11.990 Texte | 99,5 % Genauigkeit |
| DARIUS Authentische Lernendenaufsätze | Falsch positive Ergebnisse bei menschlichen Texten | 4.589 Schüleraufsätze | 0,48 % FPR |
Wir weisen die Kennzahlen für jeden Datensatz separat aus, statt Benchmarks mit unterschiedlichen Aufgaben zu mitteln.
Sprachspezifische Auswertungen verwenden, soweit anwendbar, die Konfiguration des im Produkt eingesetzten Detektors. Ergebnisse externer Benchmarks und Ranglisten folgen dem jeweils veröffentlichten Prüfprotokoll.
Wenn eine Filterung nötig ist, gilt bei Tests mit menschlichen Texten die Mindestlänge von 200 Zeichen aus dem It’s-AI-Produkt. So verzerren Texte, die die Anwendung selbst ablehnen würde, nicht die ausgewiesene Falsch-Positiv-Rate.
Genauigkeit bezeichnet den Anteil korrekter Klassifikationen in Datensätzen mit menschlichen und KI-generierten Texten. Die Falsch-Positiv-Rate (FPR) gibt an, wie häufig authentische menschliche Texte fälschlich als KI-generiert eingestuft werden. ROC-AUC, die Fläche unter der ROC-Kurve, beschreibt die Trennleistung über verschiedene Entscheidungsschwellen hinweg.