Detección de textos de IA
DetectRL-XACL 2026
96,0 %
de exactitud en DetectRL-X


Evaluamos la detección en español con DetectRL-X y medimos los falsos positivos por separado en más de 20.000 textos auténticos de estudiantes de español del corpus CAES.
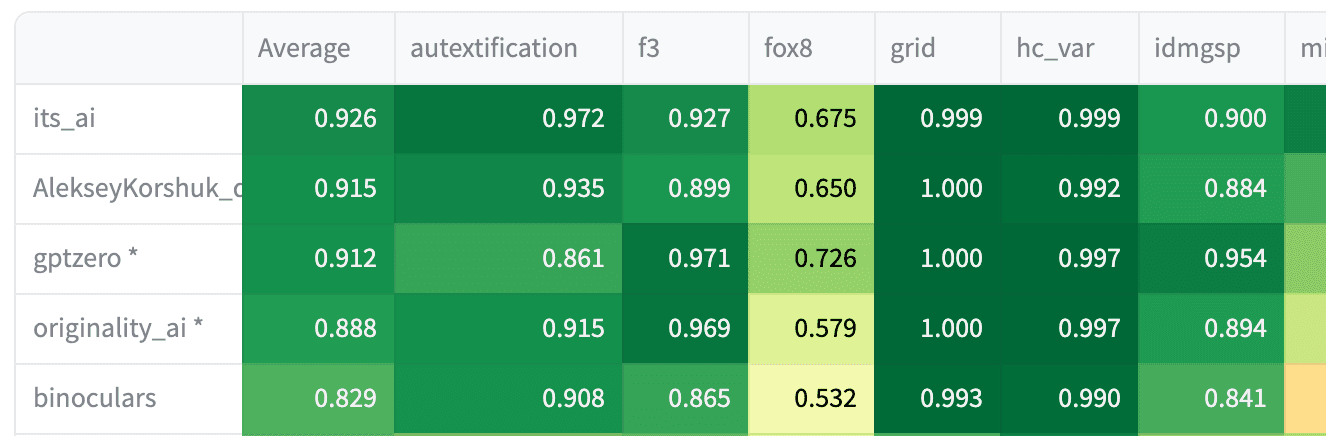
El rendimiento de It’s AI está respaldado por investigaciones publicadas y evaluaciones independientes. Nuestros resultados en MGTD aparecen en un estudio revisado por pares, y el resultado en RAID figura en la clasificación pública oficial. Ambas evaluaciones miden la detección en inglés.
MGTD reúne 15 conjuntos de datos de referencia y casi 2 millones de muestras de prueba para comparar directamente los principales detectores de IA. It’s AI obtuvo el mayor valor ROC-AUC, por delante de GPTZero, Originality AI, ZeroGPT y los demás sistemas evaluados.
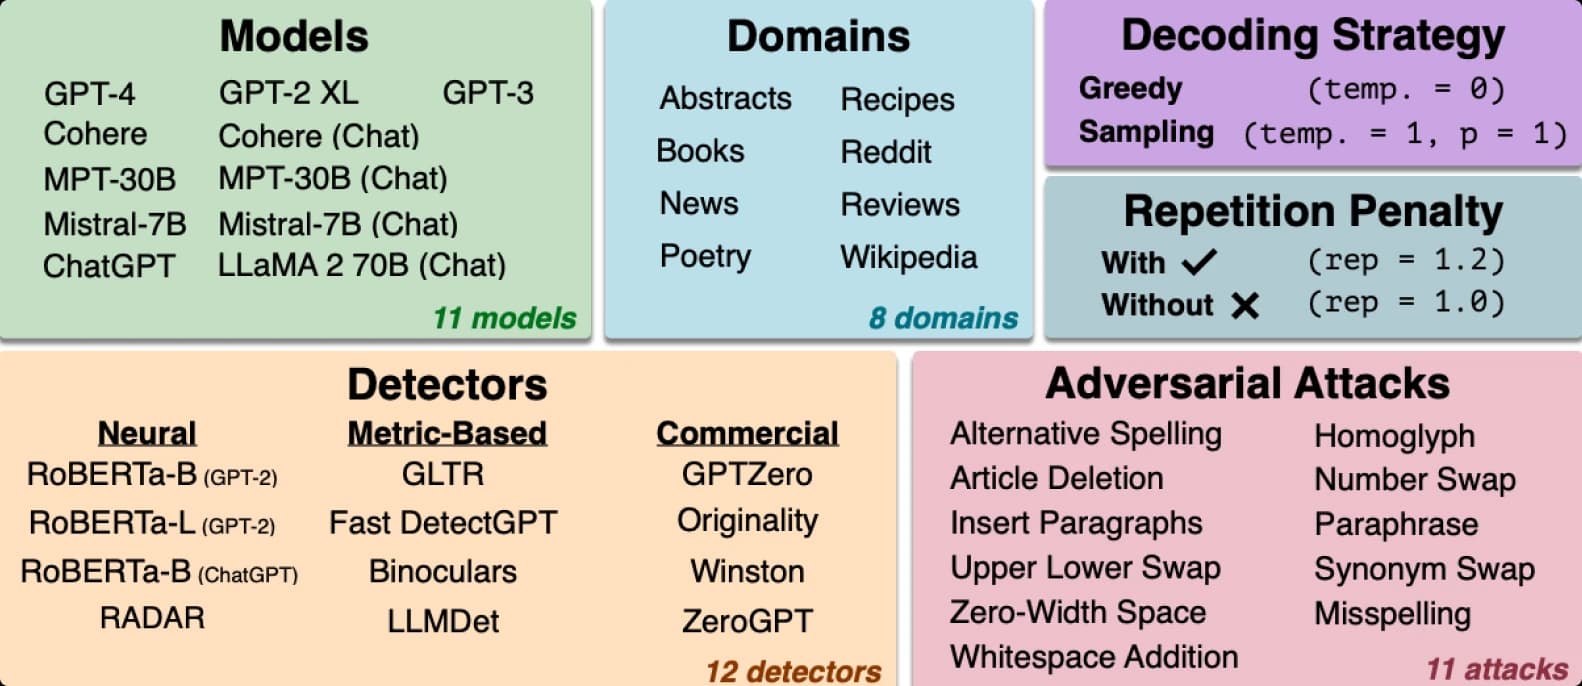
RAID somete a los detectores de IA a pruebas de robustez con distintos grandes modelos de lenguaje, ámbitos de escritura, parámetros de decodificación y modificaciones diseñadas para eludir la detección: paráfrasis, errores ortográficos, caracteres visualmente similares, manipulación de espacios y otras alteraciones realistas.
Cada benchmark enlaza al estudio, al conjunto de datos o a la página oficial correspondiente.
| Benchmark | Qué evalúa | Muestras | Resultado de It’s AI |
|---|---|---|---|
| DetectRL-X Benchmark multilingüe de uso real | Detección de textos de IA en seis ámbitos | 11.997 textos | 96,0 % Exactitud |
| CAES Textos auténticos de estudiantes de español | Falsos positivos en textos humanos | 20.629 textos de estudiantes de español | 0,72 % FPR |
Benchmark multilingüe de uso real
Detección de textos de IA en seis ámbitos
11.997 textos
Textos auténticos de estudiantes de español
Falsos positivos en textos humanos
20.629 textos de estudiantes de español
Presentamos las métricas de cada conjunto de datos por separado, sin promediar benchmarks que miden tareas diferentes.
Las evaluaciones por idioma utilizan la configuración del detector desplegado en el producto cuando corresponde. Los resultados de benchmarks y clasificaciones de terceros siguen el protocolo publicado por cada uno.
Cuando es necesario filtrar los datos, las pruebas con textos humanos aplican el mínimo de 200 caracteres exigido por It’s AI. Así, los textos que la propia aplicación rechazaría no distorsionan la tasa de falsos positivos publicada.
La exactitud (accuracy) es la proporción de clasificaciones correctas en conjuntos que incluyen textos humanos y generados por IA. La tasa de falsos positivos (FPR) indica con qué frecuencia se clasifican erróneamente textos humanos auténticos como generados por IA. ROC-AUC, el área bajo la curva ROC, mide la capacidad del detector para distinguir ambas clases a través de distintos umbrales de decisión.