Détection de textes IA
DetectRL-XACL 2026
99,4 %
d’exactitude sur DetectRL-X


Les performances en français sont évaluées sur DetectRL-X. Le taux de faux positifs est mesuré séparément sur des productions écrites authentiques d’élèves du corpus E-CALM.
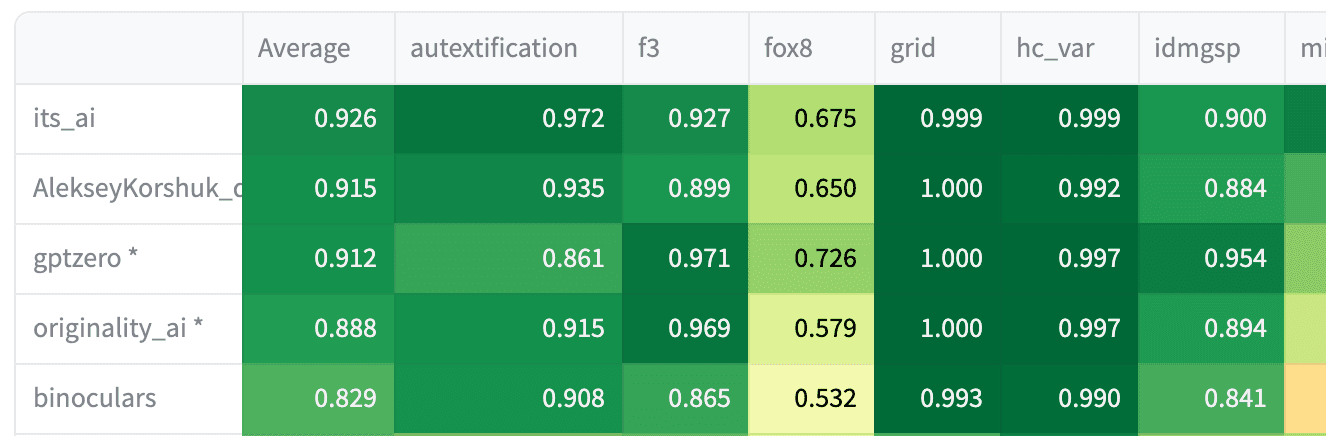
Les performances d’It’s AI sont étayées par des recherches publiées et des évaluations indépendantes. Nos résultats MGTD figurent dans une étude évaluée par les pairs, et notre résultat RAID apparaît dans le classement public officiel. Ces deux évaluations portent sur la détection en anglais.
MGTD réunit 15 jeux de données de référence et près de 2 millions d’échantillons de test pour comparer directement les principaux détecteurs d’IA. It’s AI a obtenu le meilleur score ROC-AUC, devant GPTZero, Originality AI, ZeroGPT et les autres systèmes évalués.
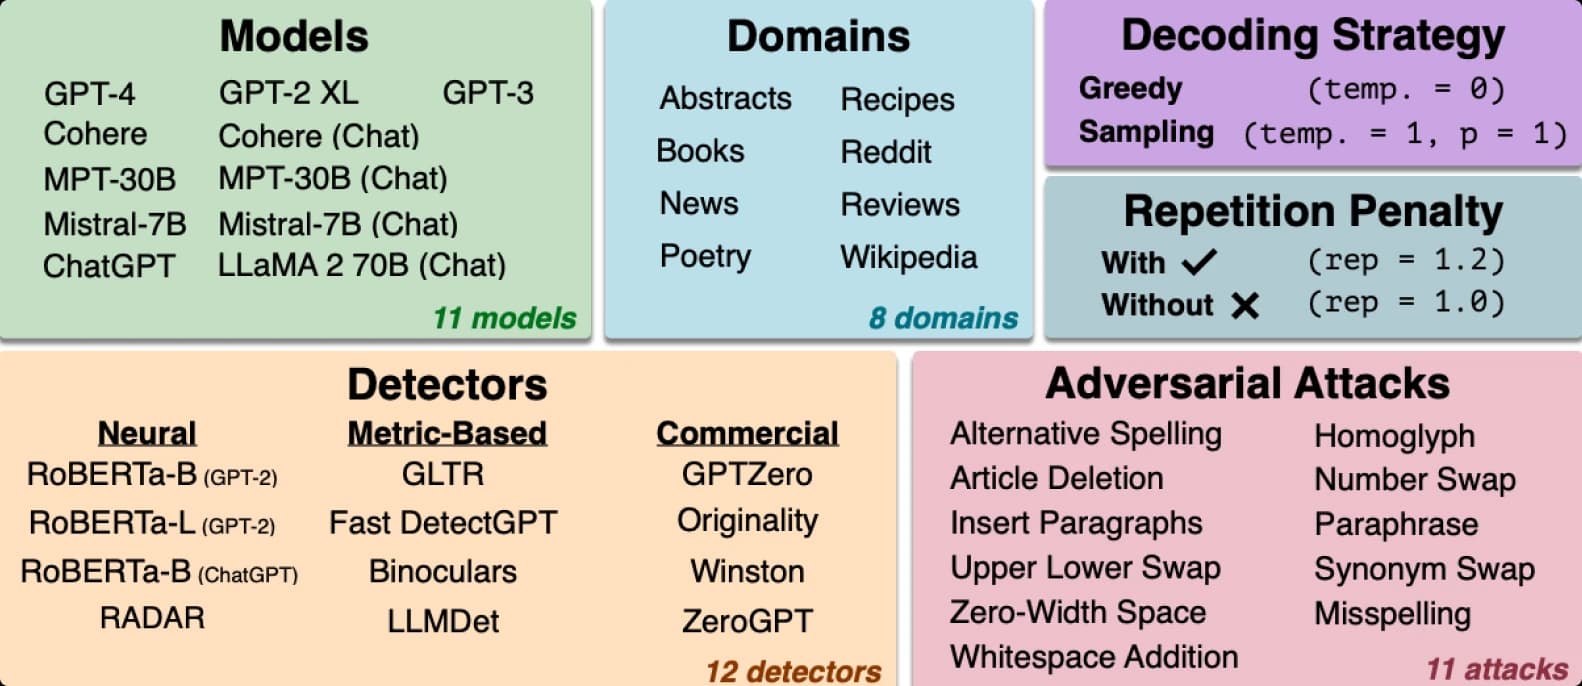
RAID teste la robustesse des détecteurs d’IA sur différents grands modèles de langage, domaines rédactionnels, paramètres de décodage et modifications destinées à tromper les détecteurs : reformulations, fautes d’orthographe, caractères visuellement similaires, manipulation des espaces et autres perturbations réalistes.
Chaque benchmark renvoie à l’étude, au jeu de données ou à la page officielle correspondante.
| Benchmark | Ce qui est évalué | Échantillons | Résultat d’It’s AI |
|---|---|---|---|
| DetectRL-X Benchmark multilingue en conditions réelles | Détection de textes générés par IA dans six domaines | 11 998 textes | 99,4 % Exactitude |
| E-CALM Écrits authentiques d’élèves | Faux positifs sur les textes humains | 2 334 textes d’élèves | 0,56 % FPR |
Benchmark multilingue en conditions réelles
Détection de textes générés par IA dans six domaines
11 998 textes
Écrits authentiques d’élèves
Faux positifs sur les textes humains
2 334 textes d’élèves
Nous présentons les mesures propres à chaque jeu de données, sans calculer de moyenne entre des benchmarks qui évaluent des tâches différentes.
Les évaluations propres à chaque langue utilisent, lorsque cela s’applique, la configuration du détecteur déployé dans le produit. Les résultats des benchmarks et classements tiers suivent leur protocole publié.
Lorsqu’un filtrage est nécessaire, les tests sur les écrits humains appliquent le minimum de 200 caractères requis par It’s AI. Les textes que l’application refuserait ne faussent donc pas le taux de faux positifs annoncé.
L’exactitude (accuracy) est la proportion de classifications correctes dans un jeu de données contenant des textes humains et générés par IA. Le taux de faux positifs (FPR) indique la fréquence à laquelle des textes humains authentiques sont classés à tort comme générés par IA. Le ROC-AUC, aire sous la courbe ROC, mesure la capacité du détecteur à distinguer les deux catégories à différents seuils de décision.