


أداء كشف النصوص المولّدة بالذكاء الاصطناعي
ASJPنصوص أكاديمية عربية
98.7%
الدقة في اختبار ASJP
DetectRL-XACL 2026
99.8%
الدقة في اختبار DetectRL-X
نقيّم أداء الكشف عن النصوص العربية باستخدام اختبارات معيارية منشورة، ونقيس الإيجابيات الكاذبة بشكل منفصل على كتابات طلابية أصلية.
تستند نتائج It’s AI إلى أبحاث منشورة واختبارات معيارية مستقلة. وردت نتائج MGTD في دراسة معيارية محكّمة، وتظهر نتيجة RAID في لوحة النتائج الرسمية المتاحة للجمهور. ويقيس كلا التقييمين الكشف في النصوص الإنجليزية.
يجمع MGTD بين 15 مجموعة بيانات معيارية وما يقارب مليوني عينة اختبار لمقارنة أبرز كواشف النصوص المولّدة بالذكاء الاصطناعي مباشرةً. حقق It’s AI أعلى قيمة لمقياس ROC-AUC، متقدمًا على GPTZero وOriginality AI وZeroGPT وغيرها من الأنظمة التي شملها التقييم.
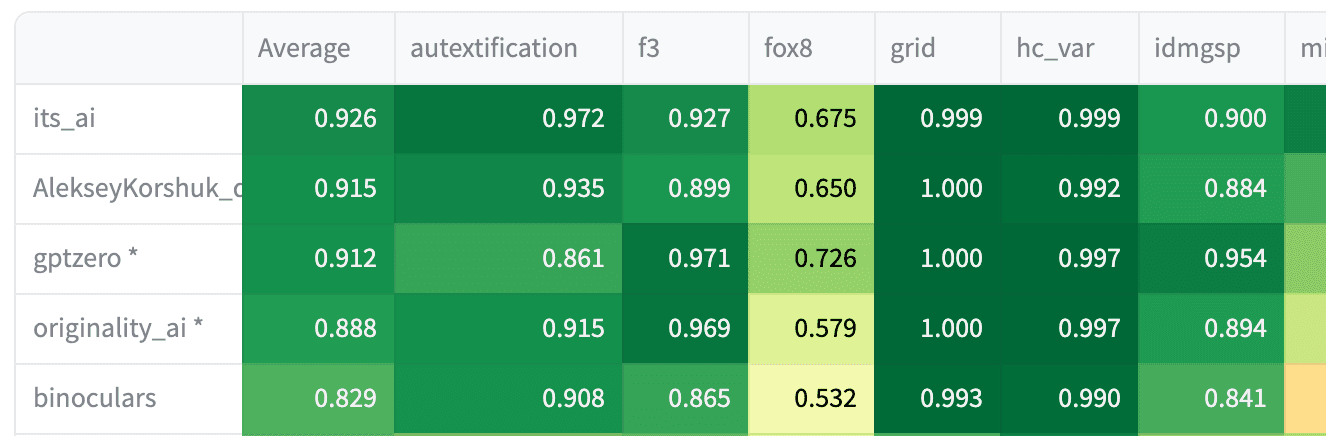
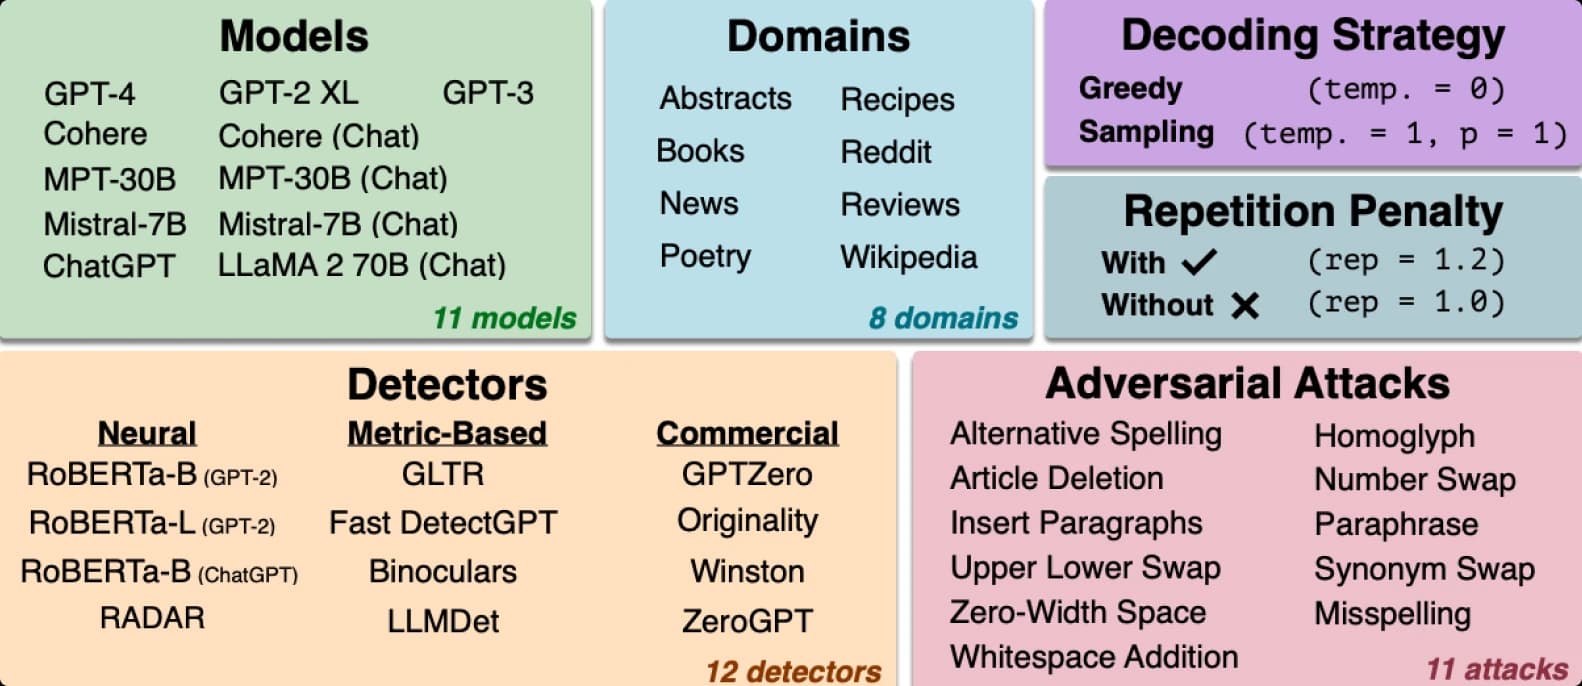
يختبر RAID متانة الكواشف عبر نماذج لغوية كبيرة ومجالات كتابية وإعدادات لفك الترميز وتعديلات تهدف إلى تضليل الكاشف، تشمل إعادة الصياغة والأخطاء الإملائية والمحارف المتشابهة بصريًا والتلاعب بالمسافات وغيرها من التغييرات الواقعية.
يرتبط كل اختبار أدناه بالدراسة أو مجموعة البيانات أو الصفحة الرسمية ذات الصلة.
| الاختبار المعياري | ما الذي يقيسه؟ | العينات | نتيجة It’s AI |
|---|---|---|---|
| ASJP اختبار معياري لنصوص أكاديمية عربية مولّدة | التمييز بين النصوص العربية البشرية والمولّدة بالذكاء الاصطناعي، بما فيها النصوص المنقّحة | ملخصات أكاديمية | 98.7% الدقة0.5% FPR |
| DetectRL-X اختبار معياري متعدد اللغات لنصوص من الواقع | كشف النصوص المولّدة بالذكاء الاصطناعي في ستة مجالات كتابية | 11,974 نصًا | 99.8% الدقة |
| AR-AES كتابات طلابية أصلية | التصنيف الخاطئ للنصوص البشرية على أنها مولّدة بالذكاء الاصطناعي | 1,242 مقالة مستوفية للشروط | 0.89% FPR |
اختبار معياري لنصوص أكاديمية عربية مولّدة
التمييز بين النصوص العربية البشرية والمولّدة بالذكاء الاصطناعي، بما فيها النصوص المنقّحة
ملخصات أكاديمية
اختبار معياري متعدد اللغات لنصوص من الواقع
كشف النصوص المولّدة بالذكاء الاصطناعي في ستة مجالات كتابية
11,974 نصًا
كتابات طلابية أصلية
التصنيف الخاطئ للنصوص البشرية على أنها مولّدة بالذكاء الاصطناعي
1,242 مقالة مستوفية للشروط
نعرض المقاييس الخاصة بكل مجموعة بيانات على حدة، بدلًا من حساب متوسط لاختبارات تقيس مهام مختلفة.
تستخدم التقييمات الخاصة بكل لغة إعدادات الكاشف المستخدم في المنتج الفعلي حيثما ينطبق ذلك. أما نتائج الاختبارات ولوحات النتائج التابعة لجهات خارجية، فتتبع بروتوكول الاختبار المنشور.
عندما يلزم ترشيح البيانات، تطبّق اختبارات الكتابة البشرية الحد الأدنى المعتمد في It’s AI وهو 200 حرف. وهكذا لا تؤثر النصوص التي يرفضها التطبيق أصلًا في معدل الإيجابيات الكاذبة المعلن.
الدقة هي نسبة التصنيفات الصحيحة في مجموعات تضم نصوصًا بشرية وأخرى مولّدة بالذكاء الاصطناعي. ويقيس معدل الإيجابيات الكاذبة (FPR) نسبة النصوص البشرية الأصلية التي تُصنَّف خطأً على أنها مولّدة بالذكاء الاصطناعي. أما ROC-AUC، أي المساحة تحت منحنى خصائص تشغيل المستقبِل، فيقيس قدرة الكاشف على التمييز بين الفئتين عبر عتبات قرار مختلفة.
